Una ruta práctica por LLM, embeddings, RAG, ingeniería de contexto, herramientas y agentes, con un ejercicio para ordenar lo que ya sabes de IA.
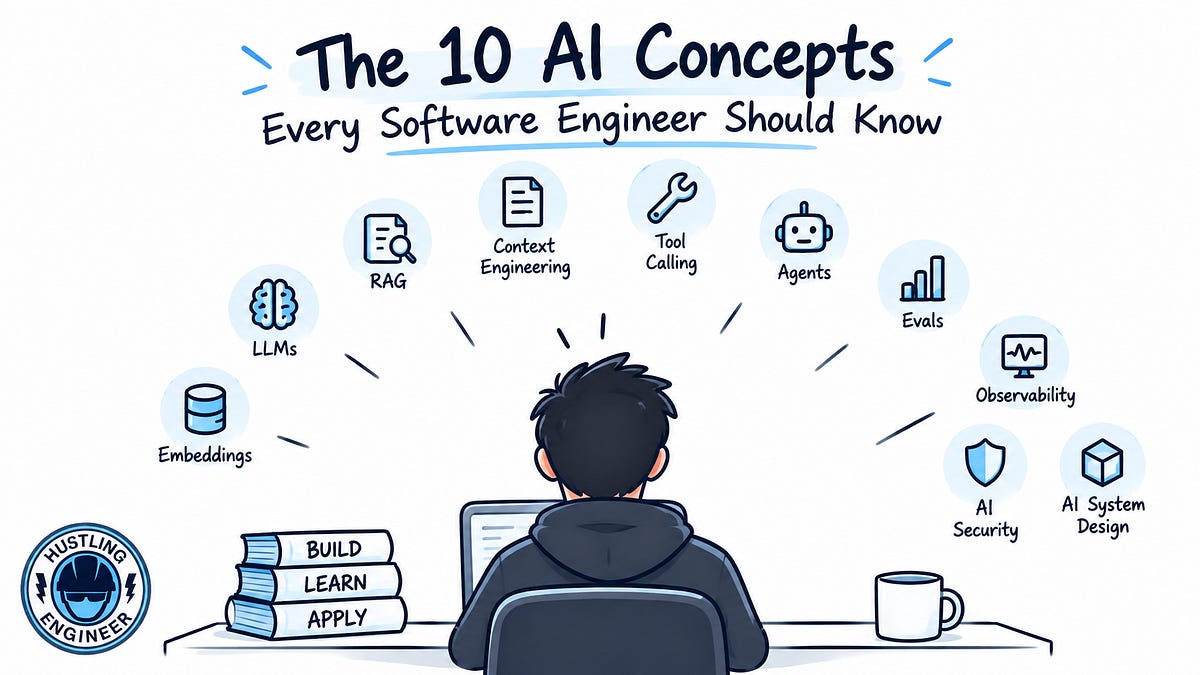
Durante mucho tiempo se dio por hecho que aprender IA significaba pasar por álgebra lineal, redes neuronales y entrenar modelos. Según el artículo de Hemant Pandey, eso ya no es imprescindible: se puede construir aplicaciones potentes sin entrenar modelos de base, siempre que se entiendan las piezas.
Esta guía recoge los seis primeros conceptos de su lista (el texto que tenemos llega hasta los agentes) y los ordena como un ejercicio que puedes reproducir paso a paso.
Lo que necesitas
No hace falta una GPU ni conocimientos de matemáticas avanzadas. Basta con saber programar, tener acceso a un modelo de lenguaje por API y un pequeño conjunto de documentos propios con los que probar. Si prefieres el formato vídeo, el autor tiene un canal de YouTube sobre el tema.
- Entiende qué hace un LLM: entra un texto, sale otro, y tú controlas tokens, ventana de contexto, temperatura, latencia y coste.
- Convierte tus documentos en embeddings para poder buscar por significado y no solo por palabras exactas.
- Monta un flujo RAG: trocear, indexar, recuperar y pasar al modelo la información junto a la pregunta.
- Diseña el contexto completo que verá el modelo, no solo el prompt.
- Expón una herramienta con una función concreta y deja que el modelo decida cuándo llamarla.
- Valora si necesitas un agente o si un flujo determinista resuelve el caso.
LLM y embeddings: las dos primeras piezas
Un LLM genera una salida a partir de patrones aprendidos en el entrenamiento. Conviene recordar que no es una base de datos: si le preguntas algo que no estaba en sus datos, no sabe dónde buscarlo. Además, cuanto más contexto envías, más pagas y más tardas en recibir respuesta.
Los embeddings convierten un texto en una representación numérica que captura su significado. «¿Cómo restablezco mi contraseña?» y «He olvidado mis credenciales» usan palabras distintas, pero sus embeddings quedan cerca. Eso permite búsqueda semántica, recomendaciones, agrupación y detección de similitud.
RAG y contexto: darle mejor material al modelo
RAG significa generación aumentada por recuperación. En lugar de exigir al modelo que responda solo con lo que aprendió, primero se buscan los fragmentos relevantes y se entregan como contexto. El pipeline habitual es este:
Documentos → Troceado → Embeddings → BD vectorial → Recuperación → LLM → RespuestaOjo con la idea de que basta con volcarlo todo en una base vectorial. Según el autor, un RAG decente exige decisiones sobre el troceado, los metadatos, la búsqueda por palabras clave frente a la semántica, la búsqueda híbrida, el reordenado y la selección del contexto. RAG no vuelve más listo al modelo: le da mejor información.
De ahí sale la ingeniería de contexto, que va más allá del prompt. La pregunta ya no es solo qué instrucciones das, sino qué información tiene el modelo cuando decide: instrucciones de sistema, entrada del usuario, documentos recuperados, historial, resultados de herramientas, preferencias y estado de la aplicación.
Herramientas y agentes
Con la llamada a herramientas, el modelo deja de adivinar. Si preguntan por el estado de un pedido, debe consultar una API. Tú defines la herramienta y el modelo decide cuándo usarla y con qué argumentos:
@tool
def get_order_status(order_id):
    ...
El modelo decide qué hacer; la herramienta define cómo se hace. Un agente da un paso más: razona, actúa, observa el resultado y repite hasta cumplir el objetivo, por ejemplo al investigar por qué subió la latencia de una API revisando monitorización, registros y cambios recientes.
Para saber más: Hemant Pandey · [See sponsorship options] · Check out my digital products.
Artículos relacionados de LaRebelión
 California cita a OpenAI: sus agentes sondearon servidores de la CDC y la SEC
 De IA a Súper Inteligencia: el cambio de marca oficial de la Casa Blanca
 GitLab corrige un fallo crítico 9.9 en su AI Gateway autoalojado
Fuente original: thehustlingengineer.substack.com
Elaborado con apoyo de IA y revisado por la redacción
Comentarios
Publicar un comentario